
python爬虫
一. 爬虫的基本原理
工作流程
- 发送请求:向目标网站发送HTTP请求
- 获取响应:接收网站返回的HTML、JSON等数据
- 解析数据:提取有用的信息
- 存储数据:将提取的数据保存到本地或数据库
- 持续爬取:根据需要继续爬取下一个页面
二. HTTP协议基础
- 请求方法:GET(获取资源)、POST(提交数据)、PUT(更新资源)、DELETE(删除资源)等
- 请求头:包含User-Agent、Cookie、Referer等信息
- 响应状态码:200(成功)、404(未找到)、403(禁止访问)、500(服务器错误)等
三. 常用的Python爬虫库
1.requests - 发送HTTP请求
1 | import requests |
2.BeautifulSoup - 解析HTML
1 | from bs4 import BeautifulSoup |
3. re - 正则表达式
1 | import requests |
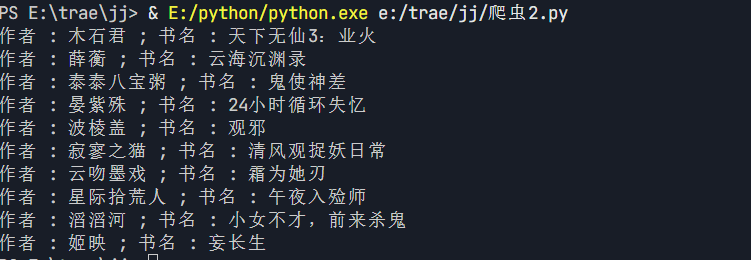
四. 爬虫的基本流程
1 分析目标网站
- 了解网站结构和数据加载方式
- 检查robots.txt文件,了解网站的爬取规则
- 分析网页源代码,确定数据提取方式
2 编写爬虫代码
- 发送HTTP请求获取页面内容
- 解析页面,提取有用信息
- 处理反爬虫机制
- 存储爬取的数据
3 测试和优化
- 测试爬虫的稳定性和效率
- 优化爬取策略,避免被封IP
- 处理异常情况,提高爬虫的健壮性
五. 反爬虫机制及应对策略
- IP限制:使用代理IP、降低请求频率(待学)
- User-Agent检测:使用真实的浏览器User-Agent
- Cookie验证:模拟登录,保持会话(待学)
- 验证码:使用OCR技术或人工识别(待学)
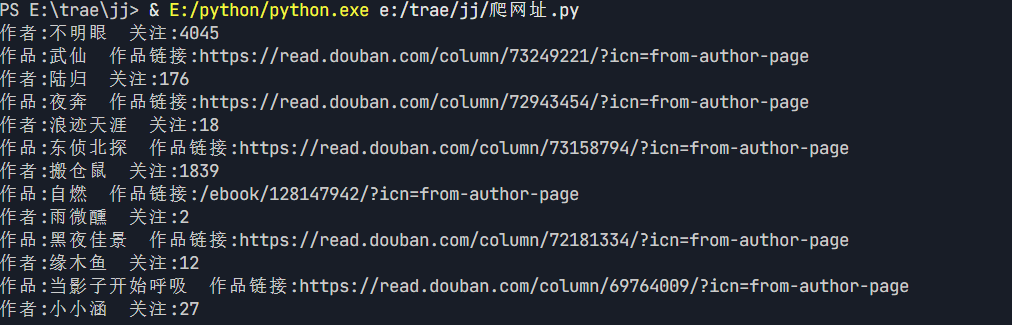
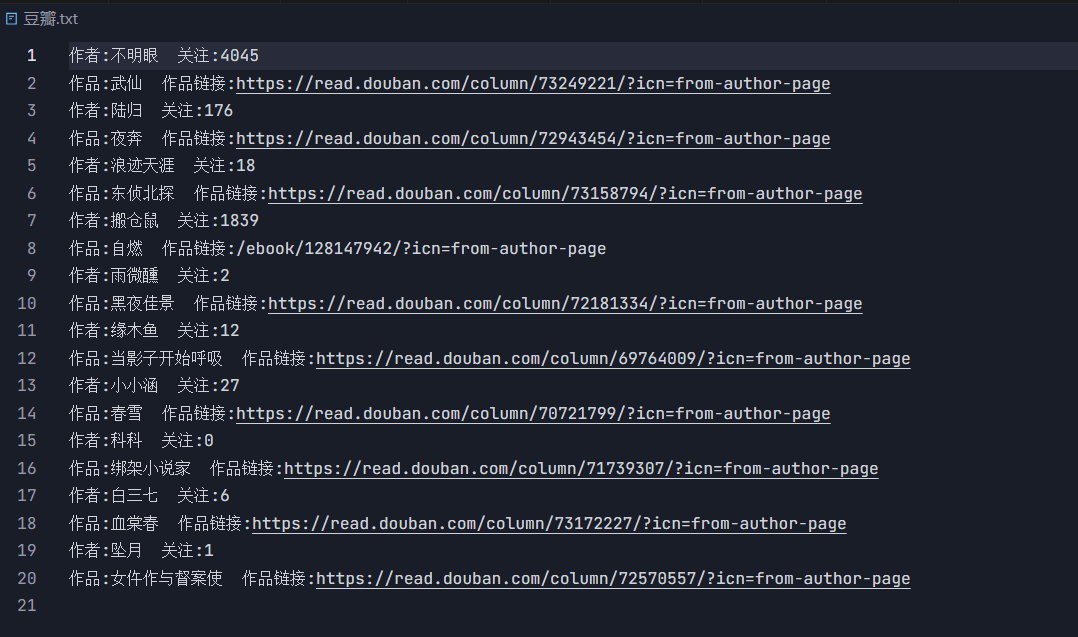
六. 实例代码 - 爬取豆瓣读书作者与其作品
1 | import requests |
本博客所有文章除特别声明外,均采用 CC BY-NC-SA 4.0 许可协议。转载请注明来源 Hello World!