一. 爬虫的基本原理

工作流程

  1. 发送请求:向目标网站发送HTTP请求
  2. 获取响应:接收网站返回的HTML、JSON等数据
  3. 解析数据:提取有用的信息
  4. 存储数据:将提取的数据保存到本地或数据库
  5. 持续爬取:根据需要继续爬取下一个页面

二. HTTP协议基础

  • 请求方法:GET(获取资源)、POST(提交数据)、PUT(更新资源)、DELETE(删除资源)等
  • 请求头:包含User-Agent、Cookie、Referer等信息
  • 响应状态码:200(成功)、404(未找到)、403(禁止访问)、500(服务器错误)等

三. 常用的Python爬虫库

1.requests - 发送HTTP请求

1
2
3
4
5
6
7
8
9
10
import requests

url = "https://www.example.com"
headers = {
"User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/146.0.0.0 Safari/537.36"
}

response = requests.get(url, headers=headers)
print(response.status_code)
print(response.text)

2.BeautifulSoup - 解析HTML

1
2
3
4
5
6
7
8
9
10
11
from bs4 import BeautifulSoup

html = response.text
soup = BeautifulSoup(html, "html.parser")

# 查找元素
title = soup.find("title").text
links = soup.find_all("a")

for link in links:
print(link.get("href"))

3. re - 正则表达式

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
import requests
import re
url = "https://read.douban.com/charts/science_fiction?dcs=charts&dcm=ranking-nav"
headers= {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/146.0.0.0 Safari/537.36 Edg/146.0.0.0'}
rest = requests.get(url,headers=headers)
rest.encoding="utf-8"
text=rest.text
#print(text)
obj = re.compile(r'<div class="title">(?P<title>.*?)</div>'
r'<div class="author"><a href="/author/(.*?)/">(?P<author>.*?)</a></div><div',re.S)
result = obj.finditer(text)
for item in result:
t=item.group('title')
a=item.group('author')
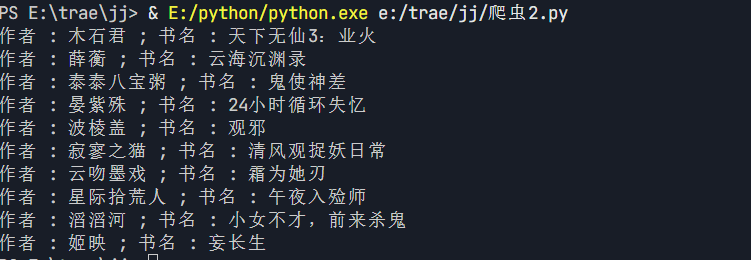
print(f"作者 : {a} ; 书名 : {t}")

正则表达式

四. 爬虫的基本流程

1 分析目标网站

  • 了解网站结构和数据加载方式
  • 检查robots.txt文件,了解网站的爬取规则
  • 分析网页源代码,确定数据提取方式

2 编写爬虫代码

  • 发送HTTP请求获取页面内容
  • 解析页面,提取有用信息
  • 处理反爬虫机制
  • 存储爬取的数据

3 测试和优化

  • 测试爬虫的稳定性和效率
  • 优化爬取策略,避免被封IP
  • 处理异常情况,提高爬虫的健壮性

五. 反爬虫机制及应对策略

  • IP限制:使用代理IP、降低请求频率(待学)
  • User-Agent检测:使用真实的浏览器User-Agent
  • Cookie验证:模拟登录,保持会话(待学)
  • 验证码:使用OCR技术或人工识别(待学)

六. 实例代码 - 爬取豆瓣读书作者与其作品

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
import requests
import re
from bs4 import BeautifulSoup
url ="https://read.douban.com/charts/mystery_fiction?dcs=charts&dcm=ranking-nav"
header={'User-Agent':'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/146.0.0.0 Safari/537.36 Edg/146.0.0.0'}
rest = requests.get(url,headers=header)
rest.encoding="utf-8"
text=rest.text
souce = BeautifulSoup(text,'html.parser')
li = souce.find_all("li")
f=open("豆瓣.txt",mode="w",encoding="utf-8")
for a in li:
name=a.find("div",attrs={"class":"title"})
div=a.find("a")
if div!=None:
h=div.get("href")
na=div.text
url2="https://read.douban.com"
url3=url2+h
rest2=requests.get(url3,headers=header)
rest2.encoding="utf-8"
souce2 = BeautifulSoup(rest2.text,'html.parser')
gz=souce2.find("div",attrs={"class":"followed-number"})
gz=gz.text
zp=souce2.find("div",attrs={"class":"title"})
zp_text=zp.find("a").text
zp_link=zp.find("a").get("href")
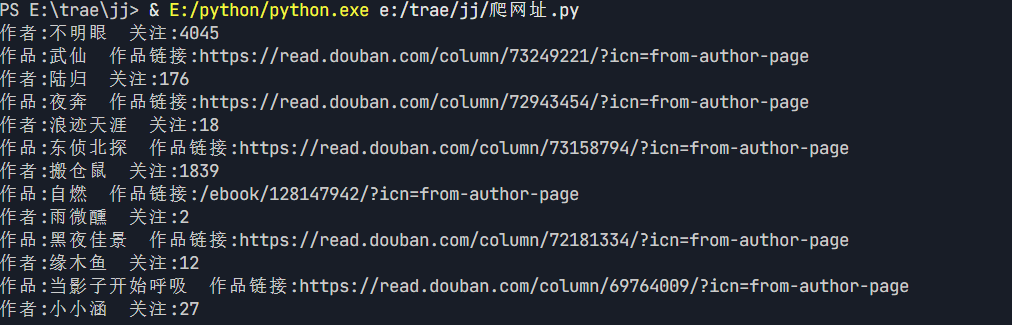
print("作者:"+na+" "+"关注:"+gz+" ")
print("作品:"+zp_text+" "+"作品链接:"+zp_link)
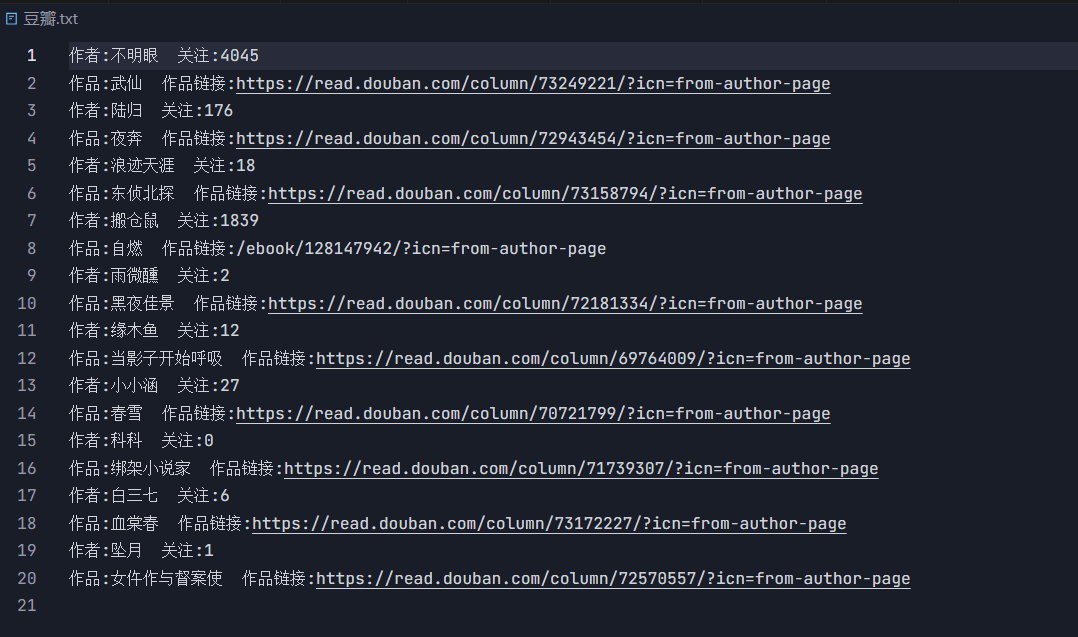
f.write("作者:"+na+" "+"关注:"+gz+" "+"\n"+"作品:"+zp_text+" "+"作品链接:"+zp_link+"\n")
f.close()

1

2